{
  "@context": "https://schema.org",
  "@id": "https://aggr.aymericbeaumet.com/items/blog-comma-ai/2026-09-16-bugs-that-broke-driving-machine-learning-edition/#webpage",
  "@type": [
    "WebPage",
    "ArchiveComponent"
  ],
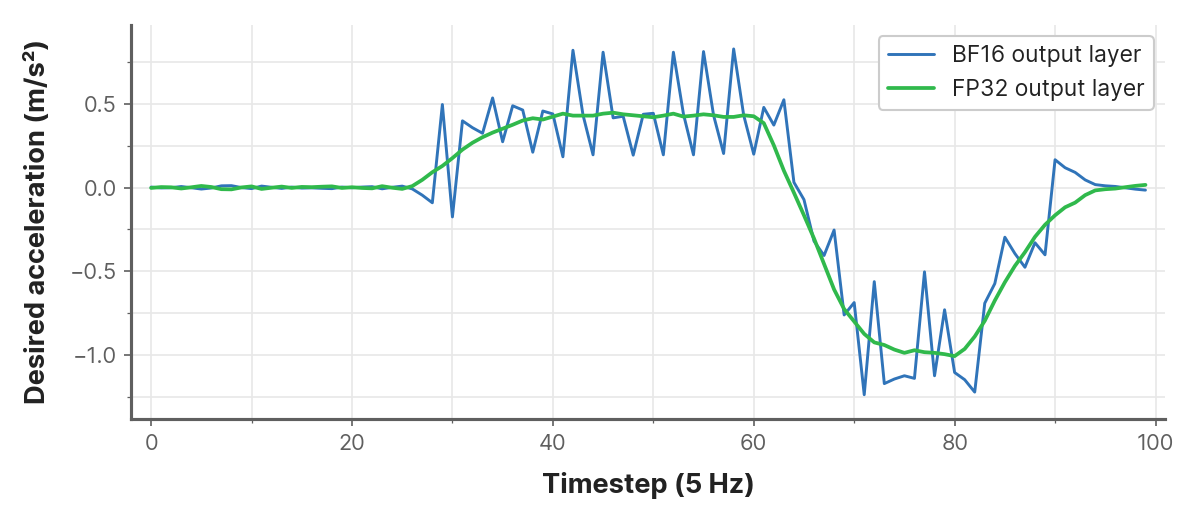
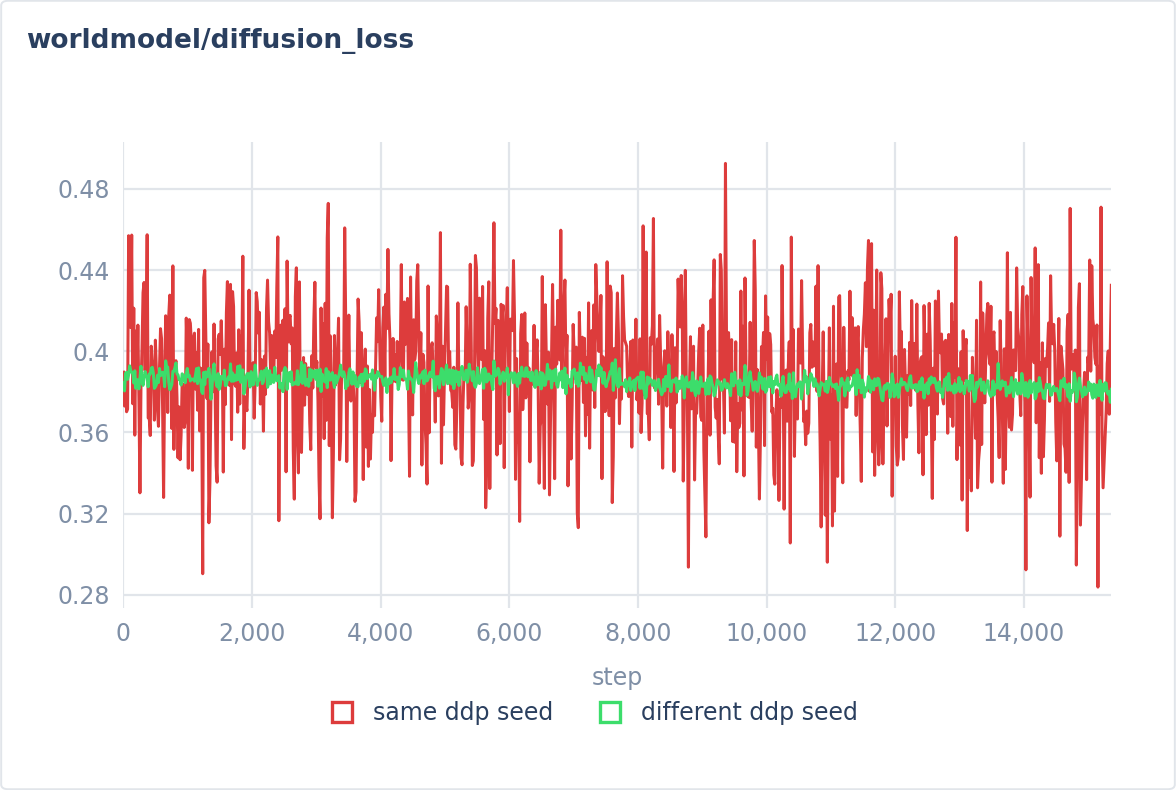
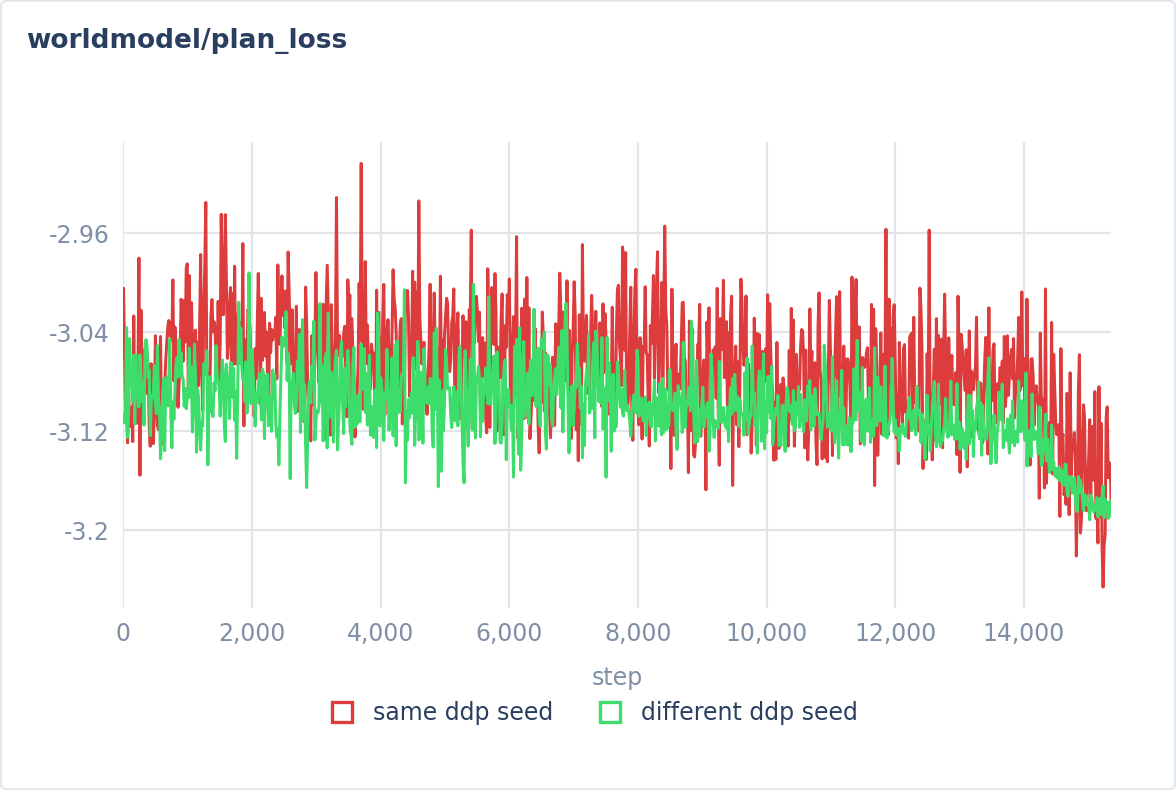
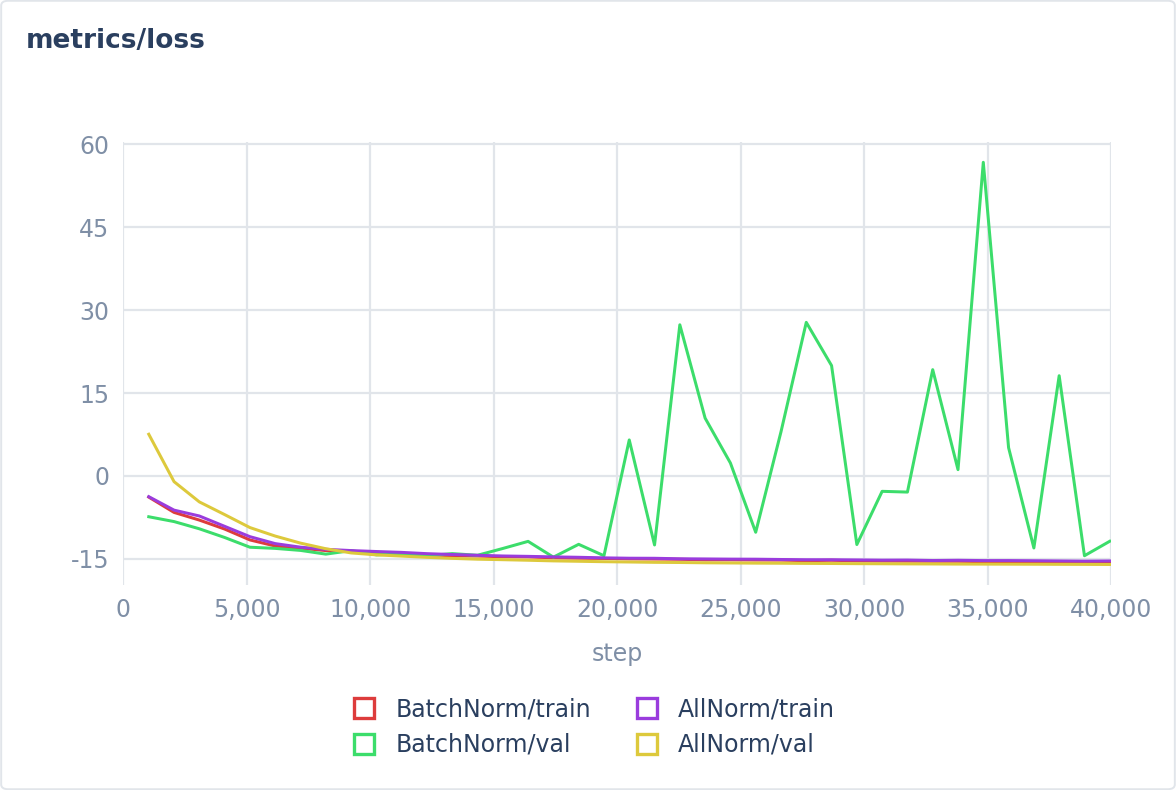
  "articleBody": "“We have solved self driving, we just need to fix the bugs.”\n\nRumor has it that the Linux kernel averages around 0.5 bugs per 1,000 lines of code. Some bugs are easy to avoid or catch with tests and metrics. Others are very good at hiding.\n\nThis is a sequel to [Bugs that broke driving](https://blog.comma.ai/driving-bugs/) with more Machine Learning related bugs.\n\nSome of these bugs affected correctness, others slowed things down or used up extra memory. They all made training or inference worse.\n\nLooking back at these bugs helps us understand where our code tends to break and how to catch problems earlier.\n\n## Output layers need to be run in high precision [Permalink](https://blog.comma.ai/ml-bugs/#output-layers-need-to-be-run-in-high-precision \"Permalink\")\n\n*September 2026.*\n\nThe world model is a diffusion transformer (DiT) which predicts the next frame and an “expert” driving plan.\n\nDuring inference, the model runs in mixed precision `bf16_fp8_nvfp4`:\n\n- Transformer MLP linears use NVFP4 (most FLOPs)\n- Attention projections, cached attention Q/K/V, and the KV cache use FP8 (saves VRAM)\n- Other layers use BF16 (not too many FLOPs)\n- Norm reductions, attention scores, and sinusoidal timestep features use FP32 (standard safe mixed precision)\n\nIn particular, the plan output layers ran in BF16. Around 30 m/s, BF16 can only represent speeds in steps of 0.125 m/s. The acceleration calculation from the plans subtracts nearby speed predictions and divides by a short time interval , magnifying the rounding errors:\n\n[![Acceleration from BF16 and FP32 plan outputs](https://blog.comma.ai/img/bug_stories_ml/output_precision.png)](https://blog.comma.ai/img/bug_stories_ml/output_precision.png \"Open image at full size\")\n\nThe fix is to promote the plan head and its inputs to FP32 *before* running it, Casting the finished plan to FP32 just gives the staircase more decimal places.\n\n```diff\n+plan_head.float()\n-plan = plan_head(features).float()\n+plan = plan_head(features.float())\n```\n\n## ConvNeXt FP16 [Permalink](https://blog.comma.ai/ml-bugs/#convnext-fp16 \"Permalink\")\n\n*August 2026.*\n\nThe driving model’s vision encoder is a ConvNeXt, with a learned multiplier on each residual branch: `x + gamma * f(x)`. At runtime, it runs in FP16.\n\nThe [pretrained checkpoint we used](https://huggingface.co/timm/convnext_xxlarge.clip_laion2b_soup) we pick had a value of almost 54 at `stages[2].blocks[29]`. After fine-tuning, some inputs push the residual past FP16’s 65,504 limit leading to `inf`.\n\nThe annoying thing is that this only triggered in some seemingly random cases, and didn’t happen in the various checks we run during model exporting to FP16.\n\nThe workaround was to divide that stage’s residual stream by four and carry the scale through its biases, multipliers, and LayerNorm epsilons:\n\n```diff\n stage = encoder.stages[2]\n+stage.downsample[1].weight.div_(4)\n+stage.downsample[1].bias.div_(4)\n+for block in stage.blocks:\n+    block.conv_dw.bias.div_(4)\n+    block.gamma.div_(4)\n+    block.norm.eps /= 16\n+encoder.stages[3].downsample[0].eps /= 16\n```\n\n## Missing desire targets [Permalink](https://blog.comma.ai/ml-bugs/#missing-desire-targets \"Permalink\")\n\n*July 2026.*\n\nThe driving model predicts “driving desire”, like turning or changing lanes.\n\nFor a while, some training data had no desire targets: we use NaNs to distinguish missing targets, and our loss helpers normally handle this by masking those targets out. But the desire loss took an `argmax` first, and did not have the NaN handling.\n\n```python\n>>> import torch\n>>> import torch.nn.functional as F\n>>> target = torch.full((1, 8), torch.nan)\n>>> target.argmax(-1)\ntensor([0])\n>>> F.cross_entropy(torch.zeros(1, 8), target.argmax(-1))\ntensor(2.0794)\n```\n\nAll those NaNs became class `0`, “no desire”, with a perfectly normal loss.\n\nThe fix replaces NaNs with zeros while keeping a mask, then uses that mask to ignore missing targets:\n\n```python\ndef num_from_nan(target):\n    valid = ~torch.isnan(target)\n    return target.masked_fill(~valid, 0).detach(), valid\n```\n\n```diff\n+target, valid = num_from_nan(target)\n loss = F.cross_entropy(logits, target.argmax(-1), reduction=\"none\")\n+loss = valid.all(-1) * loss\n```\n\n## Redundant biases drifted apart across distributed ranks [Permalink](https://blog.comma.ai/ml-bugs/#redundant-biases-drifted-apart-across-distributed-ranks \"Permalink\")\n\n*April 2026.*\n\nThe driving model has many `nn.Linear` layers. During training, we use `torch.compile`, BF16 autocast and Distributed Data Parallel (DDP) as “acceleration” recipes.\n\nSometimes, harmless redundant biases are written in the architecture:\n\n```python\na = nn.Linear(8, 8192)\nb = nn.Linear(4, 8192)\ny = a(x) + b(x[:, :4])\n```\n\nNote that the 8/4 is just illustrative, and keeps the weight gradients different while the bias gradients are identical.\n\n`a.bias` and `b.bias` will be merged by the compiler into one bias, so they get the same gradient. The compiler went one step further: it made both `.grad` tensors share the same memory.\n\nDDP synchronized them correctly, then `clip_grad_norm_` used its foreach implementation to scale that shared buffer from two CUDA blocks at once.\n\nDepending on timing, an entry could be multiplied by the clipping coefficient once or twice, giving each rank a different update.\n\nIn one recorded run, rank 0 clipped all 8,192 entries once; rank 1 clipped 384 of them twice. The drift can reach a magnitude of 0.0056 between ranks after only 50 SGD steps, while the weight matrices stayed identical.\n\nBoth biases receive the same faulty update within a rank, their sum drifts too, which can change the model’s outputs. DDP synchronizes gradients during training, so it doesn’t repair those parameter differences: the GPUs are now training different copies of the model.\n\nWe worked around it by removing the redundant biases.\n\nThis was fixed in [PyTorch 2.13.0](https://github.com/pytorch/pytorch/blob/v2.13.0/torch/_inductor/fx_passes/joint_graph.py#L801-L804) as a side effect of a [compiler optimization change](https://github.com/pytorch/pytorch/commit/6f94c6e16e1bf562f8f5514953cf9b8d47d07cdd).\n\nIt preserved `FP32 → BF16 → FP32` cast chains so smaller intermediate tensors could still be materialized: in our backward graph, that happened to keep the two bias gradients in separate FP32 buffers.\n\nNote: The foreach kernel itself still assumes the gradient buffers don’t overlap…\n\n## DDP random seed bug [Permalink](https://blog.comma.ai/ml-bugs/#ddp-random-seed-bug \"Permalink\")\n\n*August 2026.*\n\n[Torchtitan](https://github.com/pytorch/torchtitan) uses the same seed across DDP (replicate), this is correct because weight initialization should match across replicate ranks. But torchtitan then keeps that rank identical across during for training.\n\nWith ordinary tensors (not DTensors), different ranks could get identical dropout masks and diffusion noise.\n\nThe fix is to reseed each data-parallel rank after initialization (essentially):\n\n```diff\n torch.manual_seed(seed)\n model.init_weights()\n+torch.manual_seed(seed + dp_rank)\n train(model)\n```\n\nFlux [does this after initialization](https://github.com/pytorch/torchtitan/blob/68c97b0c54b0d853fefefab4ecf9e41e6a82a6b7/torchtitan/models/flux/trainer.py#L38-L50), setting `distinct_seed_mesh_dims=[\"cp\", \"dp_shard\", \"dp_replicate\"]`.\n\n[![Diffusion loss: reference run and adjusted causal run](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_diffusion_loss.png)](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_diffusion_loss.png \"Open diffusion loss plot at full size\") [![Plan loss: reference run and adjusted causal run](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_plan_loss.png)](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_plan_loss.png \"Open plan loss plot at full size\")\n\nFixing the ddp seed bug produces better world models overall and less noisy loss curves given that the diffusion noise samples are not the same across all ranks.\n\n## AllNorm [Permalink](https://blog.comma.ai/ml-bugs/#allnorm \"Permalink\")\n\n*June 2021 to April 2026.*\n\n[![BatchNorm and AllNorm training and validation loss](https://blog.comma.ai/img/bug_stories_ml/allnorm_loss.png)](https://blog.comma.ai/img/bug_stories_ml/allnorm_loss.png \"Open loss plot at full size\")\n\nTraining and validation loss for models trained with BatchNorm and AllNorm.\n\nNormalization layers are widely used in Machine Learning. BatchNorm normalizes each channel using the mean and variance across the batch and spatial dimensions. During training, it uses the current batch statistics and updates running averages. During inference, it uses those running averages.\n\nThe driving models are multi-task learners, with some tasks being more sparse than others, for example: hard brake events.\n\nOne failure mode we encountered was when a channel specializes in a rare feature. Through batches without that feature, the channel stays quiet and its BatchNorm running variance shrinks.\n\nWhen validation activates that channel again, it gets divided by a stored standard deviation that is too small, blowing up the outputs. Training can still look fine because its statistics come from the current batch: when the feature returns, the denominator grows with it.\n\nLayerNorm fixes this, but needs per input statistics at inference. On device, we want normalization folded into convolutions. Recalibrating BatchNorm running statistics offline also fixes this, but adds overhead and another training pass. Same for lowering momentum which needed extra tuning.\n\nThe best fix we came up with was pooling the whole batch, channels, and spatial dimensions into one set of statistics. We called this AllNorm.\n\n```python\nclass AllNorm(nn.Module):\n    def __init__(self):\n        super().__init__()\n        self.bn = nn.BatchNorm1d(1)\n\n    def forward(self, x):\n        return self.bn(x.reshape(-1, 1)).reshape_as(x)\n```\n\nAll channels share statistics, making it robust to this failure, and keeping the ability to fold the statistics into the convolutions.\n\nNote: With the extra compute that the [chestnut](https://blog.comma.ai/chestnut/) gives, we can now afford using LayerNorm and not deal with this!\n\n## Gigashuffle’s reusable CPU buffers [Permalink](https://blog.comma.ai/ml-bugs/#gigashuffles-reusable-cpu-buffers \"Permalink\")\n\n*July 2026.*\n\n[Gigashuffle](https://github.com/commaai/gigashuffle) returns tensors backed by reusable CPU buffers. Each reader allocates these once and fills them again for every batch:\n\n```python\n# Once per reader:\nreader_buffer[i][key] = torch.empty(shape, dtype=dtype).share_memory_()\n\n# For every batch:\ntorch.index_select(shuffle_buffer[i][key], 0, indices,\n                   out=reader_buffer[i][key])\n```\n\nNormally, each batch is copied to the GPU before the next read. Our gradient accumulation loop collected several microbatches first, so later reads overwrote batches already in the list.\n\nOne way to fix this is to clone both inputs and targets before fetching the next microbatch:\n\n```diff\n for _ in range(grad_accum):\n     inputs, targets = next(loader)\n+    inputs = {k: v.clone() for k, v in inputs.items()}\n+    targets = {k: v.clone() for k, v in targets.items()}\n     microbatches.append((inputs, targets))\n```\n\n## FSDP2 init bugs [Permalink](https://blog.comma.ai/ml-bugs/#fsdp2-init-bugs \"Permalink\")\n\n*April 2025.*\n\nWith FSDP2, we construct the model on `meta`, shard it, then use `to_empty()` to allocate the weights. Initialization has to run after allocation: not defining an init function for a parameter initializes it to the arbitrary memory value it received during allocation.\n\n```python\n>>> import torch\n>>> with torch.device(\"meta\"):\n...     model = torch.nn.Module()\n...     model.weight = torch.nn.Parameter(torch.ones(4))\n>>> _ = model.to_empty(device=\"cpu\")\n>>> model.weight.detach()\ntensor([ 3.7189e-38,  0.0000e+00, -6.3894e-37,  4.5160e-41])\n```\n\nNo clear fix here but to be paranoid about not forgetting init methods!\n\n## NCCL timeout increase didn’t do anything [Permalink](https://blog.comma.ai/ml-bugs/#nccl-timeout-increase-didnt-do-anything \"Permalink\")\n\n*July 2026.*\n\nOur RL training runs collect rollouts from the cluster. If the cluster is busy, some ranks can wait for data longer than PyTorch’s default NCCL timeout of [10 minutes](https://docs.pytorch.org/docs/2.14/distributed.html#torch.distributed.init_process_group).\n\nTo work around this, we added a barrier with a timeout of one hour before each training step, thinking we have fixed it. But that timeout was passed around, only to never be used:\n\n```python\nopts = BarrierOptions()\nopts.timeout = timeout\nopts.asyncOp = async_op\nwork = group.barrier(opts=opts)\n```\n\nThe C++ dispatcher passed it along, but NCCL implemented the barrier as an all-reduce and only forwarded `asyncOp`:\n\n```cpp\n// C++ dispatcher\nBarrierOptions opts;\nopts.timeout = std::chrono::milliseconds(timeout);\nopts.asyncOp = asyncOp;\nbackend->barrier(opts);\n\n// ProcessGroupNCCL::barrier\nAllreduceOptions arOpts;\narOpts.asyncOp = opts.asyncOp;\nauto work = allreduce_impl(barrierTensor, \"nccl:all_reduce_barrier\", arOpts);\n// opts.timeout goes nowhere.\n```\n\nThat all-reduce got its deadline from a different options object: the process group’s configuration. The watchdog checked that deadline; our `barrier(timeout=...)` argument never entered the calculation:\n\n```cpp\n// Creating the collective's work: options_ belongs to the process group.\nassignTimeoutToWork(work, options_);\n\n// Inside assignTimeoutToWork(work, option), omitting timeout extensions:\nwork->opTimeout_ = option->timeout;\n\n// Watchdog calls work.checkTimeout() with no timeout override:\nif (timeElapsed >= opTimeout_) {\n  // Report a collective timeout.\n}\n```\n\nThe fix was to give the wait for data its own Gloo group, with the timeout set on that group:\n\n```diff\n+# Once at startup, on every rank:\n+ready = dist.new_group(backend=\"gloo\", timeout=timedelta(hours=1))\n\n # Before each training step:\n-dist.barrier(timeout=timedelta(hours=1))\n+dist.barrier(group=ready)\n```\n\n## Memory leak with AdamW’s foreach updates on DTensors [Permalink](https://blog.comma.ai/ml-bugs/#memory-leak-with-adamws-foreach-updates-on-dtensors \"Permalink\")\n\n*March 2026.*\n\nAdamW batches updates into calls like `torch._foreach_mul_(params, 1 - lr * weight_decay)`. FSDP2 exposes its parameters as DTensors, so those calls go through DTensor’s dispatcher to work out how the operation applies to the shards. For foreach’s tensor lists, the dispatcher built a fresh `OpSchema` on every call, then constructed a cache key from the tensors’ shape and sharding metadata.\n\nIn the C++ key builder, `PyTuple_Pack` increments its arguments’ reference counts, but `.release()` stopped the C++ wrapper from decrementing its own reference afterward. That left an extra reference to the argument tuple on every call, so the tuples and their metadata kept piling up in CPU RAM.\n\nThe [fix](https://github.com/pytorch/pytorch/pull/176010) was to simply not release:\n\n```diff\n // torch/csrc/autograd/python_variable.cpp\n // Inside DTensor_OpSchema_recompute_comparison_key_impl (simplified):\n py::tuple args_to_hash_tup(args_to_hash.size());\n // ... fill the tuple with argument metadata ...\n comparison_key = PyTuple_Pack(\n     2, op,\n-    args_to_hash_tup.release().ptr());\n+    args_to_hash_tup.ptr());\n```\n\nThe bug affected PyTorch 2.10.0 through 2.12.1; the same fix shipped via [a later PR](https://github.com/pytorch/pytorch/pull/181792) in 2.13.0.\n\n## CUDA cache allocation [Permalink](https://blog.comma.ai/ml-bugs/#cuda-cache-allocation \"Permalink\")\n\n*February 2026.*\n\nWhen doing inference in our distributed cluster, we use an inference server with dynamic batching: [triton inference server](https://github.com/triton-inference-server). We usually benchmark at the largest batch size in isolation, and assume this will be the max VRAM the model will use. But dynamic batching reserved more VRAM, and we didn’t know why.\n\nWe traced it to how PyTorch caches freed GPU allocations, so the order of batch sizes matters. With its default native allocator, this takes just one tensor at a time:\n\n```python\nimport torch\n\ndef reserved_after(batch_sizes):\n    torch.cuda.empty_cache()  # Reset between experiments.\n    for bs in batch_sizes:\n        x = torch.empty(bs, 1024, 1024, device=\"cuda\", dtype=torch.float32)\n        del x\n    return torch.cuda.memory_reserved() // 2**20\n\nprint(reserved_after([3, 4]))     # 28 MiB\nprint(reserved_after([4, 3, 4]))  # 16 MiB\n```\n\nBatch size 3 leaves a cached 12 MiB block, batch size 4 needs 16 MiB, so the allocator keeps both. Starting with 4 lets batch 3 use 12 MiB of the larger 16 MiB block.\n\nWe flipped the warmup order to start with the largest batch:\n\n```diff\n-for bs in range(1, max_batch_size + 1):\n+for bs in range(max_batch_size, 0, -1):\n     warmup(bs)\n```\n\n## CUDA graphs don’t capture Adam’s CPU work [Permalink](https://blog.comma.ai/ml-bugs/#cuda-graphs-dont-capture-adams-cpu-work \"Permalink\")\n\n*June 2022.*\n\nWhen training with CUDA graphs, we used to capture the whole training step, optimizer step included. CUDA graphs replay only GPU work, so CPU code inside the capture runs just once!\n\nBy default, PyTorch’s eager Adam increments its step counter and computes its bias corrections, `1 - beta1**step` and `1 - beta2**step`, on the CPU:\n\n```python\n# torch/optim/adam.py — Adam._init_group() (simplified)\nstate = self.state[p]\nif len(state) == 0:  # Initialize this parameter's optimizer state once.\n    state[\"step\"] = (\n        torch.zeros((), device=p.device)\n        if group[\"capturable\"] or group[\"fused\"]\n        else torch.tensor(0.0, device=\"cpu\") # cpu?!?!\n    )\n```\n\nBack then, replay kept updating the GPU moment estimates and weights with those frozen corrections, silently reusing the value of `step` from the capture-time value. We avoided this by running the optimizer outside the graph.\n\nPyTorch 1.12.0 later added `Adam(..., capturable=True)`, putting the step counter and bias-correction math on the GPU so replay advances them too. Today, manual capture with `capturable=False` [raises an error](https://github.com/pytorch/pytorch/blob/v2.14.0/torch/optim/optimizer.py#L440-L449).\n\n## Looking back [Permalink](https://blog.comma.ai/ml-bugs/#looking-back \"Permalink\")\n\nThe recurring themes were precision, leaked or reused memory, and distributed training. Some bugs were hard to spot but preventable with better code practices. Others became obvious once we visualized model outputs during inference or inspected model state during training.\n\nCome fix the bugs that are still hiding ([https://comma.ai/jobs)](https://comma.ai/jobs\\)).\n\nYassine.\n",
  "authors": [
    "Yassine"
  ],
  "captured_at": "2026-09-19T21:30:23.395188495+00:00",
  "category": "programming",
  "content_html": "<p>“We have solved self driving, we just need to fix the bugs.”</p>\n<p>Rumor has it that the Linux kernel averages around 0.5 bugs per 1,000 lines of code. Some bugs are easy to avoid or catch with tests and metrics. Others are very good at hiding.</p>\n<p>This is a sequel to <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/driving-bugs/\">Bugs that broke driving</a> with more Machine Learning related bugs.</p>\n<p>Some of these bugs affected correctness, others slowed things down or used up extra memory. They all made training or inference worse.</p>\n<p>Looking back at these bugs helps us understand where our code tends to break and how to catch problems earlier.</p>\n<h2>Output layers need to be run in high precision <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#output-layers-need-to-be-run-in-high-precision\" title=\"Permalink\">Permalink</a></h2>\n<p><em>September 2026.</em></p>\n<p>The world model is a diffusion transformer (DiT) which predicts the next frame and an “expert” driving plan.</p>\n<p>During inference, the model runs in mixed precision <code>bf16_fp8_nvfp4</code>:</p>\n<ul>\n<li>Transformer MLP linears use NVFP4 (most FLOPs)</li>\n<li>Attention projections, cached attention Q/K/V, and the KV cache use FP8 (saves VRAM)</li>\n<li>Other layers use BF16 (not too many FLOPs)</li>\n<li>Norm reductions, attention scores, and sinusoidal timestep features use FP32 (standard safe mixed precision)</li>\n</ul>\n<p>In particular, the plan output layers ran in BF16. Around 30 m/s, BF16 can only represent speeds in steps of 0.125 m/s. The acceleration calculation from the plans subtracts nearby speed predictions and divides by a short time interval , magnifying the rounding errors:</p>\n<p><a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/img/bug_stories_ml/output_precision.png\" title=\"Open image at full size\"><picture class=\"article-picture article-picture-fallback\" style=\"--image-ratio:16 / 9\"><img src=\"https://blog.comma.ai/img/bug_stories_ml/output_precision.png\" alt=\"Acceleration from BF16 and FP32 plan outputs\" loading=\"eager\" decoding=\"async\" fetchpriority=\"high\" referrerpolicy=\"no-referrer\" class=\"progressive-image\"></picture></a></p>\n<p>The fix is to promote the plan head and its inputs to FP32 <em>before</em> running it, Casting the finished plan to FP32 just gives the staircase more decimal places.</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>plan_head.float()\n</span><span class=\"syntax-markup syntax-deleted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-deleted syntax-diff\">-</span>plan = plan_head(features).float()\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>plan = plan_head(features.float())\n</span></span></span></code></pre>\n<h2>ConvNeXt FP16 <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#convnext-fp16\" title=\"Permalink\">Permalink</a></h2>\n<p><em>August 2026.</em></p>\n<p>The driving model’s vision encoder is a ConvNeXt, with a learned multiplier on each residual branch: <code>x + gamma * f(x)</code>. At runtime, it runs in FP16.</p>\n<p>The <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://huggingface.co/timm/convnext_xxlarge.clip_laion2b_soup\">pretrained checkpoint we used</a> we pick had a value of almost 54 at <code>stages[2].blocks[29]</code>. After fine-tuning, some inputs push the residual past FP16’s 65,504 limit leading to <code>inf</code>.</p>\n<p>The annoying thing is that this only triggered in some seemingly random cases, and didn’t happen in the various checks we run during model exporting to FP16.</p>\n<p>The workaround was to divide that stage’s residual stream by four and carry the scale through its biases, multipliers, and LayerNorm epsilons:</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"> stage = encoder.stages[2]\n<span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>stage.downsample[1].weight.div_(4)\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>stage.downsample[1].bias.div_(4)\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>for block in stage.blocks:\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>    block.conv_dw.bias.div_(4)\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>    block.gamma.div_(4)\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>    block.norm.eps /= 16\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>encoder.stages[3].downsample[0].eps /= 16\n</span></span></span></code></pre>\n<h2>Missing desire targets <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#missing-desire-targets\" title=\"Permalink\">Permalink</a></h2>\n<p><em>July 2026.</em></p>\n<p>The driving model predicts “driving desire”, like turning or changing lanes.</p>\n<p>For a while, some training data had no desire targets: we use NaNs to distinguish missing targets, and our loss helpers normally handle this by masking those targets out. But the desire loss took an <code>argmax</code> first, and did not have the NaN handling.</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-statement syntax-import syntax-python\"><span class=\"syntax-keyword syntax-control syntax-import syntax-python\">import</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span></span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-statement syntax-import syntax-python\"><span class=\"syntax-keyword syntax-control syntax-import syntax-python\">import</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">nn</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">functional</span></span> <span class=\"syntax-keyword syntax-control syntax-import syntax-as syntax-python\">as</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">F</span></span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">target</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">full</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-group syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-python\">(</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span><span class=\"syntax-punctuation syntax-separator syntax-tuple syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">8</span><span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-python\">)</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">nan</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">target</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">argmax</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">-</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">tensor</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-structure syntax-list syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-list syntax-begin syntax-python\">[</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">0</span><span class=\"syntax-punctuation syntax-section syntax-list syntax-end syntax-python\">]</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">F</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">cross_entropy</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">zeros</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">8</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">target</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">argmax</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">-</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">tensor</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-float syntax-python\">2<span class=\"syntax-punctuation syntax-separator syntax-decimal syntax-python\">.</span>0794</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>All those NaNs became class <code>0</code>, “no desire”, with a perfectly normal loss.</p>\n<p>The fix replaces NaNs with zeros while keeping a mask, then uses that mask to ignore missing targets:</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-meta syntax-function syntax-python\"><span class=\"syntax-storage syntax-type syntax-function syntax-python\">def</span> <span class=\"syntax-entity syntax-name syntax-function syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">num_from_nan</span></span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-begin syntax-python\">(</span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-variable syntax-parameter syntax-python\">target</span><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-function syntax-begin syntax-python\">:</span></span>\n    <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">valid</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">~</span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">isnan</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">target</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n    <span class=\"syntax-keyword syntax-control syntax-flow syntax-return syntax-python\">return</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">target</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">masked_fill</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">~</span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">valid</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">0</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">detach</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>, <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">valid</span></span>\n</span></span></code></pre>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>target, valid = num_from_nan(target)\n</span> loss = F.cross_entropy(logits, target.argmax(-1), reduction=&quot;none&quot;)\n<span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>loss = valid.all(-1) * loss\n</span></span></span></code></pre>\n<h2>Redundant biases drifted apart across distributed ranks <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#redundant-biases-drifted-apart-across-distributed-ranks\" title=\"Permalink\">Permalink</a></h2>\n<p><em>April 2026.</em></p>\n<p>The driving model has many <code>nn.Linear</code> layers. During training, we use <code>torch.compile</code>, BF16 autocast and Distributed Data Parallel (DDP) as “acceleration” recipes.</p>\n<p>Sometimes, harmless redundant biases are written in the architecture:</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">a</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">nn</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">Linear</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">8</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">8192</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">b</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">nn</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">Linear</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">4</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">8192</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">y</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">a</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">x</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span> <span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">+</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">b</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">x</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-punctuation syntax-separator syntax-slice syntax-python\">:</span>, <span class=\"syntax-punctuation syntax-separator syntax-slice syntax-python\">:</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">4</span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>Note that the 8/4 is just illustrative, and keeps the weight gradients different while the bias gradients are identical.</p>\n<p><code>a.bias</code> and <code>b.bias</code> will be merged by the compiler into one bias, so they get the same gradient. The compiler went one step further: it made both <code>.grad</code> tensors share the same memory.</p>\n<p>DDP synchronized them correctly, then <code>clip_grad_norm_</code> used its foreach implementation to scale that shared buffer from two CUDA blocks at once.</p>\n<p>Depending on timing, an entry could be multiplied by the clipping coefficient once or twice, giving each rank a different update.</p>\n<p>In one recorded run, rank 0 clipped all 8,192 entries once; rank 1 clipped 384 of them twice. The drift can reach a magnitude of 0.0056 between ranks after only 50 SGD steps, while the weight matrices stayed identical.</p>\n<p>Both biases receive the same faulty update within a rank, their sum drifts too, which can change the model’s outputs. DDP synchronizes gradients during training, so it doesn’t repair those parameter differences: the GPUs are now training different copies of the model.</p>\n<p>We worked around it by removing the redundant biases.</p>\n<p>This was fixed in <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/pytorch/blob/v2.13.0/torch/_inductor/fx_passes/joint_graph.py#L801-L804\">PyTorch 2.13.0</a> as a side effect of a <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/pytorch/commit/6f94c6e16e1bf562f8f5514953cf9b8d47d07cdd\">compiler optimization change</a>.</p>\n<p>It preserved <code>FP32 → BF16 → FP32</code> cast chains so smaller intermediate tensors could still be materialized: in our backward graph, that happened to keep the two bias gradients in separate FP32 buffers.</p>\n<p>Note: The foreach kernel itself still assumes the gradient buffers don’t overlap…</p>\n<h2>DDP random seed bug <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#ddp-random-seed-bug\" title=\"Permalink\">Permalink</a></h2>\n<p><em>August 2026.</em></p>\n<p><a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/torchtitan\">Torchtitan</a> uses the same seed across DDP (replicate), this is correct because weight initialization should match across replicate ranks. But torchtitan then keeps that rank identical across during for training.</p>\n<p>With ordinary tensors (not DTensors), different ranks could get identical dropout masks and diffusion noise.</p>\n<p>The fix is to reseed each data-parallel rank after initialization (essentially):</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"> torch.manual_seed(seed)\n model.init_weights()\n<span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>torch.manual_seed(seed + dp_rank)\n</span> train(model)\n</span></span></code></pre>\n<p>Flux <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/torchtitan/blob/68c97b0c54b0d853fefefab4ecf9e41e6a82a6b7/torchtitan/models/flux/trainer.py#L38-L50\">does this after initialization</a>, setting <code>distinct_seed_mesh_dims=[&quot;cp&quot;, &quot;dp_shard&quot;, &quot;dp_replicate&quot;]</code>.</p>\n<p><a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_diffusion_loss.png\" title=\"Open diffusion loss plot at full size\"><picture class=\"article-picture article-picture-fallback\" style=\"--image-ratio:16 / 9\"><img src=\"https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_diffusion_loss.png\" alt=\"Diffusion loss: reference run and adjusted causal run\" loading=\"lazy\" decoding=\"async\" fetchpriority=\"low\" referrerpolicy=\"no-referrer\" class=\"progressive-image\"></picture></a> <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_plan_loss.png\" title=\"Open plan loss plot at full size\"><picture class=\"article-picture article-picture-fallback\" style=\"--image-ratio:16 / 9\"><img src=\"https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_plan_loss.png\" alt=\"Plan loss: reference run and adjusted causal run\" loading=\"lazy\" decoding=\"async\" fetchpriority=\"low\" referrerpolicy=\"no-referrer\" class=\"progressive-image\"></picture></a></p>\n<p>Fixing the ddp seed bug produces better world models overall and less noisy loss curves given that the diffusion noise samples are not the same across all ranks.</p>\n<h2>AllNorm <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#allnorm\" title=\"Permalink\">Permalink</a></h2>\n<p><em>June 2021 to April 2026.</em></p>\n<p><a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/img/bug_stories_ml/allnorm_loss.png\" title=\"Open loss plot at full size\"><picture class=\"article-picture article-picture-fallback\" style=\"--image-ratio:16 / 9\"><img src=\"https://blog.comma.ai/img/bug_stories_ml/allnorm_loss.png\" alt=\"BatchNorm and AllNorm training and validation loss\" loading=\"lazy\" decoding=\"async\" fetchpriority=\"low\" referrerpolicy=\"no-referrer\" class=\"progressive-image\"></picture></a></p>\n<p>Training and validation loss for models trained with BatchNorm and AllNorm.</p>\n<p>Normalization layers are widely used in Machine Learning. BatchNorm normalizes each channel using the mean and variance across the batch and spatial dimensions. During training, it uses the current batch statistics and updates running averages. During inference, it uses those running averages.</p>\n<p>The driving models are multi-task learners, with some tasks being more sparse than others, for example: hard brake events.</p>\n<p>One failure mode we encountered was when a channel specializes in a rare feature. Through batches without that feature, the channel stays quiet and its BatchNorm running variance shrinks.</p>\n<p>When validation activates that channel again, it gets divided by a stored standard deviation that is too small, blowing up the outputs. Training can still look fine because its statistics come from the current batch: when the feature returns, the denominator grows with it.</p>\n<p>LayerNorm fixes this, but needs per input statistics at inference. On device, we want normalization folded into convolutions. Recalibrating BatchNorm running statistics offline also fixes this, but adds overhead and another training pass. Same for lowering momentum which needed extra tuning.</p>\n<p>The best fix we came up with was pooling the whole batch, channels, and spatial dimensions into one set of statistics. We called this AllNorm.</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-meta syntax-class syntax-python\"><span class=\"syntax-storage syntax-type syntax-class syntax-python\">class</span> <span class=\"syntax-entity syntax-name syntax-class syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">AllNorm</span></span><span class=\"syntax-meta syntax-class syntax-inheritance syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-inheritance syntax-begin syntax-python\">(</span></span></span><span class=\"syntax-meta syntax-class syntax-inheritance syntax-python\"><span class=\"syntax-entity syntax-other syntax-inherited-class syntax-python\">nn<span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span>Module</span><span class=\"syntax-punctuation syntax-section syntax-inheritance syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-class syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-class syntax-begin syntax-python\">:</span></span>\n<span class=\"syntax-meta syntax-function syntax-python\">    <span class=\"syntax-storage syntax-type syntax-function syntax-python\">def</span> <span class=\"syntax-entity syntax-name syntax-function syntax-python\"><span class=\"syntax-support syntax-function syntax-magic syntax-python\">__init__</span></span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-begin syntax-python\">(</span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-variable syntax-parameter syntax-python\">self</span><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-function syntax-begin syntax-python\">:</span></span>\n        <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-support syntax-function syntax-builtin syntax-python\">super</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-support syntax-function syntax-magic syntax-python\">__init__</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n        <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-language syntax-python\">self</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">bn</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">nn</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">BatchNorm1d</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n\n<span class=\"syntax-meta syntax-function syntax-python\">    <span class=\"syntax-storage syntax-type syntax-function syntax-python\">def</span> <span class=\"syntax-entity syntax-name syntax-function syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">forward</span></span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-begin syntax-python\">(</span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-variable syntax-parameter syntax-python\">self</span><span class=\"syntax-punctuation syntax-separator syntax-parameters syntax-python\">,</span> <span class=\"syntax-variable syntax-parameter syntax-python\">x</span><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-function syntax-begin syntax-python\">:</span></span>\n        <span class=\"syntax-keyword syntax-control syntax-flow syntax-return syntax-python\">return</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-language syntax-python\">self</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">bn</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">x</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">reshape</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">-</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">reshape_as</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">x</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>All channels share statistics, making it robust to this failure, and keeping the ability to fold the statistics into the convolutions.</p>\n<p>Note: With the extra compute that the <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/chestnut/\">chestnut</a> gives, we can now afford using LayerNorm and not deal with this!</p>\n<h2>Gigashuffle’s reusable CPU buffers <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#gigashuffles-reusable-cpu-buffers\" title=\"Permalink\">Permalink</a></h2>\n<p><em>July 2026.</em></p>\n<p><a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/commaai/gigashuffle\">Gigashuffle</a> returns tensors backed by reusable CPU buffers. Each reader allocates these once and fills them again for every batch:</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> Once per reader:\n</span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">reader_buffer</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">i</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">key</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">empty</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">shape</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-variable syntax-parameter syntax-python\">dtype</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">dtype</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">share_memory_</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n\n<span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> For every batch:\n</span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">index_select</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">shuffle_buffer</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">i</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">key</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">0</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">indices</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span>\n                   <span class=\"syntax-variable syntax-parameter syntax-python\">out</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">reader_buffer</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">i</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">key</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>Normally, each batch is copied to the GPU before the next read. Our gradient accumulation loop collected several microbatches first, so later reads overwrote batches already in the list.</p>\n<p>One way to fix this is to clone both inputs and targets before fetching the next microbatch:</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"> for _ in range(grad_accum):\n     inputs, targets = next(loader)\n<span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>    inputs = {k: v.clone() for k, v in inputs.items()}\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>    targets = {k: v.clone() for k, v in targets.items()}\n</span>     microbatches.append((inputs, targets))\n</span></span></code></pre>\n<h2>FSDP2 init bugs <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#fsdp2-init-bugs\" title=\"Permalink\">Permalink</a></h2>\n<p><em>April 2025.</em></p>\n<p>With FSDP2, we construct the model on <code>meta</code>, shard it, then use <code>to_empty()</code> to allocate the weights. Initialization has to run after allocation: not defining an init function for a parameter initializes it to the arbitrary memory value it received during allocation.</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-statement syntax-import syntax-python\"><span class=\"syntax-keyword syntax-control syntax-import syntax-python\">import</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span></span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-statement syntax-with syntax-python\"><span class=\"syntax-keyword syntax-control syntax-flow syntax-with syntax-python\">with</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">device</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">meta<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span><span class=\"syntax-punctuation syntax-section syntax-block syntax-with syntax-python\">:</span></span>\n<span class=\"syntax-constant syntax-language syntax-python\">...</span>     <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">model</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">nn</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">Module</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-constant syntax-language syntax-python\">...</span>     <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">model</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">weight</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">nn</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">Parameter</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">ones</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">4</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-language syntax-python\">_</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">model</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">to_empty</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-variable syntax-parameter syntax-python\">device</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">cpu<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span><span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">&gt;</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">model</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">weight</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">detach</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">tensor</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-structure syntax-list syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-list syntax-begin syntax-python\">[</span> <span class=\"syntax-constant syntax-numeric syntax-float syntax-python\">3<span class=\"syntax-punctuation syntax-separator syntax-decimal syntax-python\">.</span>7189e-38</span><span class=\"syntax-punctuation syntax-separator syntax-list syntax-python\">,</span>  <span class=\"syntax-constant syntax-numeric syntax-float syntax-python\">0<span class=\"syntax-punctuation syntax-separator syntax-decimal syntax-python\">.</span>0000e+00</span><span class=\"syntax-punctuation syntax-separator syntax-list syntax-python\">,</span> <span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">-</span><span class=\"syntax-constant syntax-numeric syntax-float syntax-python\">6<span class=\"syntax-punctuation syntax-separator syntax-decimal syntax-python\">.</span>3894e-37</span><span class=\"syntax-punctuation syntax-separator syntax-list syntax-python\">,</span>  <span class=\"syntax-constant syntax-numeric syntax-float syntax-python\">4<span class=\"syntax-punctuation syntax-separator syntax-decimal syntax-python\">.</span>5160e-41</span><span class=\"syntax-punctuation syntax-section syntax-list syntax-end syntax-python\">]</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>No clear fix here but to be paranoid about not forgetting init methods!</p>\n<h2>NCCL timeout increase didn’t do anything <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#nccl-timeout-increase-didnt-do-anything\" title=\"Permalink\">Permalink</a></h2>\n<p><em>July 2026.</em></p>\n<p>Our RL training runs collect rollouts from the cluster. If the cluster is busy, some ranks can wait for data longer than PyTorch’s default NCCL timeout of <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://docs.pytorch.org/docs/2.14/distributed.html#torch.distributed.init_process_group\">10 minutes</a>.</p>\n<p>To work around this, we added a barrier with a timeout of one hour before each training step, thinking we have fixed it. But that timeout was passed around, only to never be used:</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">opts</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">BarrierOptions</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n<span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">opts</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">timeout</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">timeout</span></span>\n<span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">opts</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">asyncOp</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">async_op</span></span>\n<span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">work</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">group</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">barrier</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-variable syntax-parameter syntax-python\">opts</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">opts</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>The C++ dispatcher passed it along, but NCCL implemented the barrier as an all-reduce and only forwarded <code>asyncOp</code>:</p>\n<pre><code class=\"language-cpp\"><span class=\"code-snippet\" data-language=\"C++\"><span class=\"syntax-source syntax-c++\"><span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> C++ dispatcher\n</span>BarrierOptions opts<span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\nopts<span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-c++\">.</span><span class=\"syntax-variable syntax-other syntax-readwrite syntax-member syntax-c++\">timeout</span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-c\">=</span> <span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-variable syntax-function syntax-c++\">std<span class=\"syntax-punctuation syntax-accessor syntax-c++\">::</span></span><span class=\"syntax-variable syntax-function syntax-c++\">chrono<span class=\"syntax-punctuation syntax-accessor syntax-c++\">::</span></span><span class=\"syntax-variable syntax-function syntax-c++\">milliseconds</span><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-c++\">(</span></span></span><span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\">timeout</span></span><span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-c++\">)</span></span></span><span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\nopts<span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-c++\">.</span><span class=\"syntax-variable syntax-other syntax-readwrite syntax-member syntax-c++\">asyncOp</span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-c\">=</span> asyncOp<span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\nbackend<span class=\"syntax-punctuation syntax-accessor syntax-arrow syntax-c++\">-&gt;</span><span class=\"syntax-meta syntax-method-call syntax-c++\"><span class=\"syntax-variable syntax-function syntax-member syntax-c++\">barrier</span><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-c++\">(</span></span></span><span class=\"syntax-meta syntax-method-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\">opts</span></span><span class=\"syntax-meta syntax-method-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-c++\">)</span></span></span><span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\n\n<span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> ProcessGroupNCCL::barrier\n</span>AllreduceOptions arOpts<span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\narOpts<span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-c++\">.</span><span class=\"syntax-variable syntax-other syntax-readwrite syntax-member syntax-c++\">asyncOp</span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-c\">=</span> opts<span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-c++\">.</span><span class=\"syntax-variable syntax-other syntax-readwrite syntax-member syntax-c++\">asyncOp</span><span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\n<span class=\"syntax-storage syntax-type syntax-c\">auto</span> work <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-c\">=</span> <span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-variable syntax-function syntax-c++\">allreduce_impl</span><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-c++\">(</span></span></span><span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\">barrierTensor<span class=\"syntax-punctuation syntax-separator syntax-c++\">,</span> <span class=\"syntax-string syntax-quoted syntax-double syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-c\">&quot;</span>nccl:all_reduce_barrier<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-c\">&quot;</span></span><span class=\"syntax-punctuation syntax-separator syntax-c++\">,</span> arOpts</span></span><span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-c++\">)</span></span></span><span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\n<span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> opts.timeout goes nowhere.\n</span></span></span></code></pre>\n<p>That all-reduce got its deadline from a different options object: the process group’s configuration. The watchdog checked that deadline; our <code>barrier(timeout=...)</code> argument never entered the calculation:</p>\n<pre><code class=\"language-cpp\"><span class=\"code-snippet\" data-language=\"C++\"><span class=\"syntax-source syntax-c++\"><span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> Creating the collective&#39;s work: options_ belongs to the process group.\n</span><span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-variable syntax-function syntax-c++\">assignTimeoutToWork</span><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-c++\">(</span></span></span><span class=\"syntax-meta syntax-function-call syntax-c++\"><span class=\"syntax-meta syntax-group syntax-c++\">work<span class=\"syntax-punctuation syntax-separator syntax-c++\">,</span> options_</span><span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-c++\">)</span></span></span><span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\n\n<span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> Inside assignTimeoutToWork(work, option), omitting timeout extensions:\n</span>work<span class=\"syntax-punctuation syntax-accessor syntax-arrow syntax-c++\">-&gt;</span><span class=\"syntax-variable syntax-other syntax-readwrite syntax-member syntax-c++\">opTimeout_</span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-c\">=</span> option<span class=\"syntax-punctuation syntax-accessor syntax-arrow syntax-c++\">-&gt;</span><span class=\"syntax-variable syntax-other syntax-readwrite syntax-member syntax-c++\">timeout</span><span class=\"syntax-punctuation syntax-terminator syntax-c++\">;</span>\n\n<span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> Watchdog calls work.checkTimeout() with no timeout override:\n</span><span class=\"syntax-keyword syntax-control syntax-c++\">if</span> <span class=\"syntax-meta syntax-group syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-c++\">(</span>timeElapsed <span class=\"syntax-keyword syntax-operator syntax-comparison syntax-c\">&gt;=</span> opTimeout_<span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-c++\">)</span></span> <span class=\"syntax-meta syntax-block syntax-c++\"><span class=\"syntax-punctuation syntax-section syntax-block syntax-begin syntax-c++\">{</span>\n  <span class=\"syntax-comment syntax-line syntax-double-slash syntax-c\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-c\">//</span> Report a collective timeout.\n</span><span class=\"syntax-punctuation syntax-section syntax-block syntax-end syntax-c++\">}</span></span>\n</span></span></code></pre>\n<p>The fix was to give the wait for data its own Gloo group, with the timeout set on that group:</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span># Once at startup, on every rank:\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>ready = dist.new_group(backend=&quot;gloo&quot;, timeout=timedelta(hours=1))\n</span>\n # Before each training step:\n<span class=\"syntax-markup syntax-deleted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-deleted syntax-diff\">-</span>dist.barrier(timeout=timedelta(hours=1))\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>dist.barrier(group=ready)\n</span></span></span></code></pre>\n<h2>Memory leak with AdamW’s foreach updates on DTensors <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#memory-leak-with-adamws-foreach-updates-on-dtensors\" title=\"Permalink\">Permalink</a></h2>\n<p><em>March 2026.</em></p>\n<p>AdamW batches updates into calls like <code>torch._foreach_mul_(params, 1 - lr * weight_decay)</code>. FSDP2 exposes its parameters as DTensors, so those calls go through DTensor’s dispatcher to work out how the operation applies to the shards. For foreach’s tensor lists, the dispatcher built a fresh <code>OpSchema</code> on every call, then constructed a cache key from the tensors’ shape and sharding metadata.</p>\n<p>In the C++ key builder, <code>PyTuple_Pack</code> increments its arguments’ reference counts, but <code>.release()</code> stopped the C++ wrapper from decrementing its own reference afterward. That left an extra reference to the argument tuple on every call, so the tuples and their metadata kept piling up in CPU RAM.</p>\n<p>The <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/pytorch/pull/176010\">fix</a> was to simply not release:</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"> // torch/csrc/autograd/python_variable.cpp\n // Inside DTensor_OpSchema_recompute_comparison_key_impl (simplified):\n py::tuple args_to_hash_tup(args_to_hash.size());\n // ... fill the tuple with argument metadata ...\n comparison_key = PyTuple_Pack(\n     2, op,\n<span class=\"syntax-markup syntax-deleted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-deleted syntax-diff\">-</span>    args_to_hash_tup.release().ptr());\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>    args_to_hash_tup.ptr());\n</span></span></span></code></pre>\n<p>The bug affected PyTorch 2.10.0 through 2.12.1; the same fix shipped via <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/pytorch/pull/181792\">a later PR</a> in 2.13.0.</p>\n<h2>CUDA cache allocation <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#cuda-cache-allocation\" title=\"Permalink\">Permalink</a></h2>\n<p><em>February 2026.</em></p>\n<p>When doing inference in our distributed cluster, we use an inference server with dynamic batching: <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/triton-inference-server\">triton inference server</a>. We usually benchmark at the largest batch size in isolation, and assume this will be the max VRAM the model will use. But dynamic batching reserved more VRAM, and we didn’t know why.</p>\n<p>We traced it to how PyTorch caches freed GPU allocations, so the order of batch sizes matters. With its default native allocator, this takes just one tensor at a time:</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-meta syntax-statement syntax-import syntax-python\"><span class=\"syntax-keyword syntax-control syntax-import syntax-python\">import</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span></span></span>\n\n<span class=\"syntax-meta syntax-function syntax-python\"><span class=\"syntax-storage syntax-type syntax-function syntax-python\">def</span> <span class=\"syntax-entity syntax-name syntax-function syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">reserved_after</span></span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-begin syntax-python\">(</span></span><span class=\"syntax-meta syntax-function syntax-parameters syntax-python\"><span class=\"syntax-variable syntax-parameter syntax-python\">batch_sizes</span><span class=\"syntax-punctuation syntax-section syntax-parameters syntax-end syntax-python\">)</span></span><span class=\"syntax-meta syntax-function syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-function syntax-begin syntax-python\">:</span></span>\n    <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">cuda</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">empty_cache</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>  <span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> Reset between experiments.\n</span>    <span class=\"syntax-meta syntax-statement syntax-for syntax-python\"><span class=\"syntax-keyword syntax-control syntax-flow syntax-for syntax-python\">for</span> <span class=\"syntax-meta syntax-generic-name syntax-python\">bs</span> <span class=\"syntax-meta syntax-statement syntax-for syntax-python\"><span class=\"syntax-keyword syntax-control syntax-flow syntax-for syntax-in syntax-python\">in</span></span></span><span class=\"syntax-meta syntax-statement syntax-for syntax-python\"> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">batch_sizes</span></span><span class=\"syntax-punctuation syntax-section syntax-block syntax-for syntax-python\">:</span></span>\n        <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">x</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">empty</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">bs</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1024</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">1024</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-variable syntax-parameter syntax-python\">device</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">cuda<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-variable syntax-parameter syntax-python\">dtype</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">float32</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n        <span class=\"syntax-keyword syntax-other syntax-del syntax-python\">del</span> <span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">x</span></span>\n    <span class=\"syntax-keyword syntax-control syntax-flow syntax-return syntax-python\">return</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">cuda</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">memory_reserved</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span> <span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">/</span><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">/</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">2</span><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">*</span><span class=\"syntax-keyword syntax-operator syntax-arithmetic syntax-python\">*</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">20</span>\n\n<span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-support syntax-function syntax-builtin syntax-python\">print</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">reserved_after</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-structure syntax-list syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-list syntax-begin syntax-python\">[</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">3</span><span class=\"syntax-punctuation syntax-separator syntax-list syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">4</span><span class=\"syntax-punctuation syntax-section syntax-list syntax-end syntax-python\">]</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>     <span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> 28 MiB\n</span><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-support syntax-function syntax-builtin syntax-python\">print</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">reserved_after</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-structure syntax-list syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-list syntax-begin syntax-python\">[</span><span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">4</span><span class=\"syntax-punctuation syntax-separator syntax-list syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">3</span><span class=\"syntax-punctuation syntax-separator syntax-list syntax-python\">,</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">4</span><span class=\"syntax-punctuation syntax-section syntax-list syntax-end syntax-python\">]</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>  <span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> 16 MiB\n</span></span></span></code></pre>\n<p>Batch size 3 leaves a cached 12 MiB block, batch size 4 needs 16 MiB, so the allocator keeps both. Starting with 4 lets batch 3 use 12 MiB of the larger 16 MiB block.</p>\n<p>We flipped the warmup order to start with the largest batch:</p>\n<pre><code class=\"language-diff\"><span class=\"code-snippet\" data-language=\"Diff\"><span class=\"syntax-source syntax-diff\"><span class=\"syntax-markup syntax-deleted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-deleted syntax-diff\">-</span>for bs in range(1, max_batch_size + 1):\n</span><span class=\"syntax-markup syntax-inserted syntax-diff\"><span class=\"syntax-punctuation syntax-definition syntax-inserted syntax-diff\">+</span>for bs in range(max_batch_size, 0, -1):\n</span>     warmup(bs)\n</span></span></code></pre>\n<h2>CUDA graphs don’t capture Adam’s CPU work <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#cuda-graphs-dont-capture-adams-cpu-work\" title=\"Permalink\">Permalink</a></h2>\n<p><em>June 2022.</em></p>\n<p>When training with CUDA graphs, we used to capture the whole training step, optimizer step included. CUDA graphs replay only GPU work, so CPU code inside the capture runs just once!</p>\n<p>By default, PyTorch’s eager Adam increments its step counter and computes its bias corrections, <code>1 - beta1**step</code> and <code>1 - beta2**step</code>, on the CPU:</p>\n<pre><code class=\"language-python\"><span class=\"code-snippet\" data-language=\"Python\"><span class=\"syntax-source syntax-python\"><span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> torch/optim/adam.py — Adam._init_group() (simplified)\n</span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">state</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-language syntax-python\">self</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">state</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">p</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span>\n<span class=\"syntax-meta syntax-statement syntax-if syntax-python\"><span class=\"syntax-keyword syntax-control syntax-flow syntax-conditional syntax-python\">if</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-support syntax-function syntax-builtin syntax-python\">len</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">state</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span> <span class=\"syntax-keyword syntax-operator syntax-comparison syntax-python\">==</span> <span class=\"syntax-constant syntax-numeric syntax-integer syntax-decimal syntax-python\">0</span><span class=\"syntax-punctuation syntax-section syntax-block syntax-conditional syntax-python\">:</span></span>  <span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> Initialize this parameter&#39;s optimizer state once.\n</span>    <span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">state</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">step<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span> <span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span> <span class=\"syntax-meta syntax-group syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-python\">(</span>\n        <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">zeros</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-group syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-group syntax-begin syntax-python\">(</span><span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-python\">)</span></span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-variable syntax-parameter syntax-python\">device</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">p</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span><span class=\"syntax-meta syntax-generic-name syntax-python\">device</span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span>\n        <span class=\"syntax-keyword syntax-control syntax-flow syntax-if syntax-inline syntax-python\">if</span> <span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">group</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">capturable<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span> <span class=\"syntax-keyword syntax-operator syntax-logical syntax-python\">or</span> <span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">group</span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-begin syntax-python\">[</span></span><span class=\"syntax-meta syntax-item-access syntax-arguments syntax-python\"><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">fused<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span></span><span class=\"syntax-meta syntax-item-access syntax-python\"><span class=\"syntax-punctuation syntax-section syntax-brackets syntax-end syntax-python\">]</span></span>\n        <span class=\"syntax-keyword syntax-control syntax-flow syntax-else syntax-inline syntax-python\">else</span> <span class=\"syntax-meta syntax-function-call syntax-python\"><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-meta syntax-generic-name syntax-python\">torch</span><span class=\"syntax-punctuation syntax-accessor syntax-dot syntax-python\">.</span></span><span class=\"syntax-meta syntax-qualified-name syntax-python\"><span class=\"syntax-variable syntax-function syntax-python\">tensor</span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-begin syntax-python\">(</span><span class=\"syntax-meta syntax-function-call syntax-arguments syntax-python\"><span class=\"syntax-constant syntax-numeric syntax-float syntax-python\">0<span class=\"syntax-punctuation syntax-separator syntax-decimal syntax-python\">.</span>0</span><span class=\"syntax-punctuation syntax-separator syntax-arguments syntax-python\">,</span> <span class=\"syntax-variable syntax-parameter syntax-python\">device</span><span class=\"syntax-keyword syntax-operator syntax-assignment syntax-python\">=</span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-string syntax-begin syntax-python\">&quot;</span></span></span><span class=\"syntax-meta syntax-string syntax-python\"><span class=\"syntax-string syntax-quoted syntax-double syntax-python\">cpu<span class=\"syntax-punctuation syntax-definition syntax-string syntax-end syntax-python\">&quot;</span></span></span></span><span class=\"syntax-punctuation syntax-section syntax-arguments syntax-end syntax-python\">)</span></span> <span class=\"syntax-comment syntax-line syntax-number-sign syntax-python\"><span class=\"syntax-punctuation syntax-definition syntax-comment syntax-python\">#</span> cpu?!?!\n</span>    <span class=\"syntax-punctuation syntax-section syntax-group syntax-end syntax-python\">)</span></span>\n</span></span></code></pre>\n<p>Back then, replay kept updating the GPU moment estimates and weights with those frozen corrections, silently reusing the value of <code>step</code> from the capture-time value. We avoided this by running the optimizer outside the graph.</p>\n<p>PyTorch 1.12.0 later added <code>Adam(..., capturable=True)</code>, putting the step counter and bias-correction math on the GPU so replay advances them too. Today, manual capture with <code>capturable=False</code> <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://github.com/pytorch/pytorch/blob/v2.14.0/torch/optim/optimizer.py#L440-L449\">raises an error</a>.</p>\n<h2>Looking back <a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://blog.comma.ai/ml-bugs/#looking-back\" title=\"Permalink\">Permalink</a></h2>\n<p>The recurring themes were precision, leaked or reused memory, and distributed training. Some bugs were hard to spot but preventable with better code practices. Others became obvious once we visualized model outputs during inference or inspected model state during training.</p>\n<p>Come fix the bugs that are still hiding (<a target=\"_blank\" rel=\"noopener noreferrer\" href=\"https://comma.ai/jobs)\">https://comma.ai/jobs)</a>.</p>\n<p>Yassine.</p>\n",
  "content_markdown": "“We have solved self driving, we just need to fix the bugs.”\n\nRumor has it that the Linux kernel averages around 0.5 bugs per 1,000 lines of code. Some bugs are easy to avoid or catch with tests and metrics. Others are very good at hiding.\n\nThis is a sequel to [Bugs that broke driving](https://blog.comma.ai/driving-bugs/) with more Machine Learning related bugs.\n\nSome of these bugs affected correctness, others slowed things down or used up extra memory. They all made training or inference worse.\n\nLooking back at these bugs helps us understand where our code tends to break and how to catch problems earlier.\n\n## Output layers need to be run in high precision [Permalink](https://blog.comma.ai/ml-bugs/#output-layers-need-to-be-run-in-high-precision \"Permalink\")\n\n*September 2026.*\n\nThe world model is a diffusion transformer (DiT) which predicts the next frame and an “expert” driving plan.\n\nDuring inference, the model runs in mixed precision `bf16_fp8_nvfp4`:\n\n- Transformer MLP linears use NVFP4 (most FLOPs)\n- Attention projections, cached attention Q/K/V, and the KV cache use FP8 (saves VRAM)\n- Other layers use BF16 (not too many FLOPs)\n- Norm reductions, attention scores, and sinusoidal timestep features use FP32 (standard safe mixed precision)\n\nIn particular, the plan output layers ran in BF16. Around 30 m/s, BF16 can only represent speeds in steps of 0.125 m/s. The acceleration calculation from the plans subtracts nearby speed predictions and divides by a short time interval , magnifying the rounding errors:\n\n[![Acceleration from BF16 and FP32 plan outputs](https://blog.comma.ai/img/bug_stories_ml/output_precision.png)](https://blog.comma.ai/img/bug_stories_ml/output_precision.png \"Open image at full size\")\n\nThe fix is to promote the plan head and its inputs to FP32 *before* running it, Casting the finished plan to FP32 just gives the staircase more decimal places.\n\n```diff\n+plan_head.float()\n-plan = plan_head(features).float()\n+plan = plan_head(features.float())\n```\n\n## ConvNeXt FP16 [Permalink](https://blog.comma.ai/ml-bugs/#convnext-fp16 \"Permalink\")\n\n*August 2026.*\n\nThe driving model’s vision encoder is a ConvNeXt, with a learned multiplier on each residual branch: `x + gamma * f(x)`. At runtime, it runs in FP16.\n\nThe [pretrained checkpoint we used](https://huggingface.co/timm/convnext_xxlarge.clip_laion2b_soup) we pick had a value of almost 54 at `stages[2].blocks[29]`. After fine-tuning, some inputs push the residual past FP16’s 65,504 limit leading to `inf`.\n\nThe annoying thing is that this only triggered in some seemingly random cases, and didn’t happen in the various checks we run during model exporting to FP16.\n\nThe workaround was to divide that stage’s residual stream by four and carry the scale through its biases, multipliers, and LayerNorm epsilons:\n\n```diff\n stage = encoder.stages[2]\n+stage.downsample[1].weight.div_(4)\n+stage.downsample[1].bias.div_(4)\n+for block in stage.blocks:\n+    block.conv_dw.bias.div_(4)\n+    block.gamma.div_(4)\n+    block.norm.eps /= 16\n+encoder.stages[3].downsample[0].eps /= 16\n```\n\n## Missing desire targets [Permalink](https://blog.comma.ai/ml-bugs/#missing-desire-targets \"Permalink\")\n\n*July 2026.*\n\nThe driving model predicts “driving desire”, like turning or changing lanes.\n\nFor a while, some training data had no desire targets: we use NaNs to distinguish missing targets, and our loss helpers normally handle this by masking those targets out. But the desire loss took an `argmax` first, and did not have the NaN handling.\n\n```python\n>>> import torch\n>>> import torch.nn.functional as F\n>>> target = torch.full((1, 8), torch.nan)\n>>> target.argmax(-1)\ntensor([0])\n>>> F.cross_entropy(torch.zeros(1, 8), target.argmax(-1))\ntensor(2.0794)\n```\n\nAll those NaNs became class `0`, “no desire”, with a perfectly normal loss.\n\nThe fix replaces NaNs with zeros while keeping a mask, then uses that mask to ignore missing targets:\n\n```python\ndef num_from_nan(target):\n    valid = ~torch.isnan(target)\n    return target.masked_fill(~valid, 0).detach(), valid\n```\n\n```diff\n+target, valid = num_from_nan(target)\n loss = F.cross_entropy(logits, target.argmax(-1), reduction=\"none\")\n+loss = valid.all(-1) * loss\n```\n\n## Redundant biases drifted apart across distributed ranks [Permalink](https://blog.comma.ai/ml-bugs/#redundant-biases-drifted-apart-across-distributed-ranks \"Permalink\")\n\n*April 2026.*\n\nThe driving model has many `nn.Linear` layers. During training, we use `torch.compile`, BF16 autocast and Distributed Data Parallel (DDP) as “acceleration” recipes.\n\nSometimes, harmless redundant biases are written in the architecture:\n\n```python\na = nn.Linear(8, 8192)\nb = nn.Linear(4, 8192)\ny = a(x) + b(x[:, :4])\n```\n\nNote that the 8/4 is just illustrative, and keeps the weight gradients different while the bias gradients are identical.\n\n`a.bias` and `b.bias` will be merged by the compiler into one bias, so they get the same gradient. The compiler went one step further: it made both `.grad` tensors share the same memory.\n\nDDP synchronized them correctly, then `clip_grad_norm_` used its foreach implementation to scale that shared buffer from two CUDA blocks at once.\n\nDepending on timing, an entry could be multiplied by the clipping coefficient once or twice, giving each rank a different update.\n\nIn one recorded run, rank 0 clipped all 8,192 entries once; rank 1 clipped 384 of them twice. The drift can reach a magnitude of 0.0056 between ranks after only 50 SGD steps, while the weight matrices stayed identical.\n\nBoth biases receive the same faulty update within a rank, their sum drifts too, which can change the model’s outputs. DDP synchronizes gradients during training, so it doesn’t repair those parameter differences: the GPUs are now training different copies of the model.\n\nWe worked around it by removing the redundant biases.\n\nThis was fixed in [PyTorch 2.13.0](https://github.com/pytorch/pytorch/blob/v2.13.0/torch/_inductor/fx_passes/joint_graph.py#L801-L804) as a side effect of a [compiler optimization change](https://github.com/pytorch/pytorch/commit/6f94c6e16e1bf562f8f5514953cf9b8d47d07cdd).\n\nIt preserved `FP32 → BF16 → FP32` cast chains so smaller intermediate tensors could still be materialized: in our backward graph, that happened to keep the two bias gradients in separate FP32 buffers.\n\nNote: The foreach kernel itself still assumes the gradient buffers don’t overlap…\n\n## DDP random seed bug [Permalink](https://blog.comma.ai/ml-bugs/#ddp-random-seed-bug \"Permalink\")\n\n*August 2026.*\n\n[Torchtitan](https://github.com/pytorch/torchtitan) uses the same seed across DDP (replicate), this is correct because weight initialization should match across replicate ranks. But torchtitan then keeps that rank identical across during for training.\n\nWith ordinary tensors (not DTensors), different ranks could get identical dropout masks and diffusion noise.\n\nThe fix is to reseed each data-parallel rank after initialization (essentially):\n\n```diff\n torch.manual_seed(seed)\n model.init_weights()\n+torch.manual_seed(seed + dp_rank)\n train(model)\n```\n\nFlux [does this after initialization](https://github.com/pytorch/torchtitan/blob/68c97b0c54b0d853fefefab4ecf9e41e6a82a6b7/torchtitan/models/flux/trainer.py#L38-L50), setting `distinct_seed_mesh_dims=[\"cp\", \"dp_shard\", \"dp_replicate\"]`.\n\n[![Diffusion loss: reference run and adjusted causal run](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_diffusion_loss.png)](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_diffusion_loss.png \"Open diffusion loss plot at full size\") [![Plan loss: reference run and adjusted causal run](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_plan_loss.png)](https://blog.comma.ai/img/bug_stories_ml/ddp_worldmodel_plan_loss.png \"Open plan loss plot at full size\")\n\nFixing the ddp seed bug produces better world models overall and less noisy loss curves given that the diffusion noise samples are not the same across all ranks.\n\n## AllNorm [Permalink](https://blog.comma.ai/ml-bugs/#allnorm \"Permalink\")\n\n*June 2021 to April 2026.*\n\n[![BatchNorm and AllNorm training and validation loss](https://blog.comma.ai/img/bug_stories_ml/allnorm_loss.png)](https://blog.comma.ai/img/bug_stories_ml/allnorm_loss.png \"Open loss plot at full size\")\n\nTraining and validation loss for models trained with BatchNorm and AllNorm.\n\nNormalization layers are widely used in Machine Learning. BatchNorm normalizes each channel using the mean and variance across the batch and spatial dimensions. During training, it uses the current batch statistics and updates running averages. During inference, it uses those running averages.\n\nThe driving models are multi-task learners, with some tasks being more sparse than others, for example: hard brake events.\n\nOne failure mode we encountered was when a channel specializes in a rare feature. Through batches without that feature, the channel stays quiet and its BatchNorm running variance shrinks.\n\nWhen validation activates that channel again, it gets divided by a stored standard deviation that is too small, blowing up the outputs. Training can still look fine because its statistics come from the current batch: when the feature returns, the denominator grows with it.\n\nLayerNorm fixes this, but needs per input statistics at inference. On device, we want normalization folded into convolutions. Recalibrating BatchNorm running statistics offline also fixes this, but adds overhead and another training pass. Same for lowering momentum which needed extra tuning.\n\nThe best fix we came up with was pooling the whole batch, channels, and spatial dimensions into one set of statistics. We called this AllNorm.\n\n```python\nclass AllNorm(nn.Module):\n    def __init__(self):\n        super().__init__()\n        self.bn = nn.BatchNorm1d(1)\n\n    def forward(self, x):\n        return self.bn(x.reshape(-1, 1)).reshape_as(x)\n```\n\nAll channels share statistics, making it robust to this failure, and keeping the ability to fold the statistics into the convolutions.\n\nNote: With the extra compute that the [chestnut](https://blog.comma.ai/chestnut/) gives, we can now afford using LayerNorm and not deal with this!\n\n## Gigashuffle’s reusable CPU buffers [Permalink](https://blog.comma.ai/ml-bugs/#gigashuffles-reusable-cpu-buffers \"Permalink\")\n\n*July 2026.*\n\n[Gigashuffle](https://github.com/commaai/gigashuffle) returns tensors backed by reusable CPU buffers. Each reader allocates these once and fills them again for every batch:\n\n```python\n# Once per reader:\nreader_buffer[i][key] = torch.empty(shape, dtype=dtype).share_memory_()\n\n# For every batch:\ntorch.index_select(shuffle_buffer[i][key], 0, indices,\n                   out=reader_buffer[i][key])\n```\n\nNormally, each batch is copied to the GPU before the next read. Our gradient accumulation loop collected several microbatches first, so later reads overwrote batches already in the list.\n\nOne way to fix this is to clone both inputs and targets before fetching the next microbatch:\n\n```diff\n for _ in range(grad_accum):\n     inputs, targets = next(loader)\n+    inputs = {k: v.clone() for k, v in inputs.items()}\n+    targets = {k: v.clone() for k, v in targets.items()}\n     microbatches.append((inputs, targets))\n```\n\n## FSDP2 init bugs [Permalink](https://blog.comma.ai/ml-bugs/#fsdp2-init-bugs \"Permalink\")\n\n*April 2025.*\n\nWith FSDP2, we construct the model on `meta`, shard it, then use `to_empty()` to allocate the weights. Initialization has to run after allocation: not defining an init function for a parameter initializes it to the arbitrary memory value it received during allocation.\n\n```python\n>>> import torch\n>>> with torch.device(\"meta\"):\n...     model = torch.nn.Module()\n...     model.weight = torch.nn.Parameter(torch.ones(4))\n>>> _ = model.to_empty(device=\"cpu\")\n>>> model.weight.detach()\ntensor([ 3.7189e-38,  0.0000e+00, -6.3894e-37,  4.5160e-41])\n```\n\nNo clear fix here but to be paranoid about not forgetting init methods!\n\n## NCCL timeout increase didn’t do anything [Permalink](https://blog.comma.ai/ml-bugs/#nccl-timeout-increase-didnt-do-anything \"Permalink\")\n\n*July 2026.*\n\nOur RL training runs collect rollouts from the cluster. If the cluster is busy, some ranks can wait for data longer than PyTorch’s default NCCL timeout of [10 minutes](https://docs.pytorch.org/docs/2.14/distributed.html#torch.distributed.init_process_group).\n\nTo work around this, we added a barrier with a timeout of one hour before each training step, thinking we have fixed it. But that timeout was passed around, only to never be used:\n\n```python\nopts = BarrierOptions()\nopts.timeout = timeout\nopts.asyncOp = async_op\nwork = group.barrier(opts=opts)\n```\n\nThe C++ dispatcher passed it along, but NCCL implemented the barrier as an all-reduce and only forwarded `asyncOp`:\n\n```cpp\n// C++ dispatcher\nBarrierOptions opts;\nopts.timeout = std::chrono::milliseconds(timeout);\nopts.asyncOp = asyncOp;\nbackend->barrier(opts);\n\n// ProcessGroupNCCL::barrier\nAllreduceOptions arOpts;\narOpts.asyncOp = opts.asyncOp;\nauto work = allreduce_impl(barrierTensor, \"nccl:all_reduce_barrier\", arOpts);\n// opts.timeout goes nowhere.\n```\n\nThat all-reduce got its deadline from a different options object: the process group’s configuration. The watchdog checked that deadline; our `barrier(timeout=...)` argument never entered the calculation:\n\n```cpp\n// Creating the collective's work: options_ belongs to the process group.\nassignTimeoutToWork(work, options_);\n\n// Inside assignTimeoutToWork(work, option), omitting timeout extensions:\nwork->opTimeout_ = option->timeout;\n\n// Watchdog calls work.checkTimeout() with no timeout override:\nif (timeElapsed >= opTimeout_) {\n  // Report a collective timeout.\n}\n```\n\nThe fix was to give the wait for data its own Gloo group, with the timeout set on that group:\n\n```diff\n+# Once at startup, on every rank:\n+ready = dist.new_group(backend=\"gloo\", timeout=timedelta(hours=1))\n\n # Before each training step:\n-dist.barrier(timeout=timedelta(hours=1))\n+dist.barrier(group=ready)\n```\n\n## Memory leak with AdamW’s foreach updates on DTensors [Permalink](https://blog.comma.ai/ml-bugs/#memory-leak-with-adamws-foreach-updates-on-dtensors \"Permalink\")\n\n*March 2026.*\n\nAdamW batches updates into calls like `torch._foreach_mul_(params, 1 - lr * weight_decay)`. FSDP2 exposes its parameters as DTensors, so those calls go through DTensor’s dispatcher to work out how the operation applies to the shards. For foreach’s tensor lists, the dispatcher built a fresh `OpSchema` on every call, then constructed a cache key from the tensors’ shape and sharding metadata.\n\nIn the C++ key builder, `PyTuple_Pack` increments its arguments’ reference counts, but `.release()` stopped the C++ wrapper from decrementing its own reference afterward. That left an extra reference to the argument tuple on every call, so the tuples and their metadata kept piling up in CPU RAM.\n\nThe [fix](https://github.com/pytorch/pytorch/pull/176010) was to simply not release:\n\n```diff\n // torch/csrc/autograd/python_variable.cpp\n // Inside DTensor_OpSchema_recompute_comparison_key_impl (simplified):\n py::tuple args_to_hash_tup(args_to_hash.size());\n // ... fill the tuple with argument metadata ...\n comparison_key = PyTuple_Pack(\n     2, op,\n-    args_to_hash_tup.release().ptr());\n+    args_to_hash_tup.ptr());\n```\n\nThe bug affected PyTorch 2.10.0 through 2.12.1; the same fix shipped via [a later PR](https://github.com/pytorch/pytorch/pull/181792) in 2.13.0.\n\n## CUDA cache allocation [Permalink](https://blog.comma.ai/ml-bugs/#cuda-cache-allocation \"Permalink\")\n\n*February 2026.*\n\nWhen doing inference in our distributed cluster, we use an inference server with dynamic batching: [triton inference server](https://github.com/triton-inference-server). We usually benchmark at the largest batch size in isolation, and assume this will be the max VRAM the model will use. But dynamic batching reserved more VRAM, and we didn’t know why.\n\nWe traced it to how PyTorch caches freed GPU allocations, so the order of batch sizes matters. With its default native allocator, this takes just one tensor at a time:\n\n```python\nimport torch\n\ndef reserved_after(batch_sizes):\n    torch.cuda.empty_cache()  # Reset between experiments.\n    for bs in batch_sizes:\n        x = torch.empty(bs, 1024, 1024, device=\"cuda\", dtype=torch.float32)\n        del x\n    return torch.cuda.memory_reserved() // 2**20\n\nprint(reserved_after([3, 4]))     # 28 MiB\nprint(reserved_after([4, 3, 4]))  # 16 MiB\n```\n\nBatch size 3 leaves a cached 12 MiB block, batch size 4 needs 16 MiB, so the allocator keeps both. Starting with 4 lets batch 3 use 12 MiB of the larger 16 MiB block.\n\nWe flipped the warmup order to start with the largest batch:\n\n```diff\n-for bs in range(1, max_batch_size + 1):\n+for bs in range(max_batch_size, 0, -1):\n     warmup(bs)\n```\n\n## CUDA graphs don’t capture Adam’s CPU work [Permalink](https://blog.comma.ai/ml-bugs/#cuda-graphs-dont-capture-adams-cpu-work \"Permalink\")\n\n*June 2022.*\n\nWhen training with CUDA graphs, we used to capture the whole training step, optimizer step included. CUDA graphs replay only GPU work, so CPU code inside the capture runs just once!\n\nBy default, PyTorch’s eager Adam increments its step counter and computes its bias corrections, `1 - beta1**step` and `1 - beta2**step`, on the CPU:\n\n```python\n# torch/optim/adam.py — Adam._init_group() (simplified)\nstate = self.state[p]\nif len(state) == 0:  # Initialize this parameter's optimizer state once.\n    state[\"step\"] = (\n        torch.zeros((), device=p.device)\n        if group[\"capturable\"] or group[\"fused\"]\n        else torch.tensor(0.0, device=\"cpu\") # cpu?!?!\n    )\n```\n\nBack then, replay kept updating the GPU moment estimates and weights with those frozen corrections, silently reusing the value of `step` from the capture-time value. We avoided this by running the optimizer outside the graph.\n\nPyTorch 1.12.0 later added `Adam(..., capturable=True)`, putting the step counter and bias-correction math on the GPU so replay advances them too. Today, manual capture with `capturable=False` [raises an error](https://github.com/pytorch/pytorch/blob/v2.14.0/torch/optim/optimizer.py#L440-L449).\n\n## Looking back [Permalink](https://blog.comma.ai/ml-bugs/#looking-back \"Permalink\")\n\nThe recurring themes were precision, leaked or reused memory, and distributed training. Some bugs were hard to spot but preventable with better code practices. Others became obvious once we visualized model outputs during inference or inspected model state during training.\n\nCome fix the bugs that are still hiding ([https://comma.ai/jobs)](https://comma.ai/jobs\\)).\n\nYassine.\n",
  "dateCreated": "2026-09-19T21:30:23.395188495+00:00",
  "date_created": "2026-09-16T20:00:00+00:00",
  "date_modified": "2026-09-16T20:00:00+00:00",
  "date_published": "2026-09-16T20:00:00+00:00",
  "description": "“We have solved self driving, we just need to fix the bugs.” Rumor has it that the Linux kernel averages around 0.5 bugs per 1,000 lines of code. Some bugs are easy to avoid or catch with tests and metrics. Others are very good at hiding.…",
  "external_url": "https://blog.comma.ai/ml-bugs/",
  "git": {
    "commit": "ebb0941c5c06a2ab2377342d607535262a3e969e",
    "path": "items/blog-comma-ai/2026/09/2026-09-16-bugs-that-broke-driving-machine-learning-edition.md",
    "permalink": "https://github.com/aymericbeaumet/aggr-instance/blob/ebb0941c5c06a2ab2377342d607535262a3e969e/items/blog-comma-ai/2026/09/2026-09-16-bugs-that-broke-driving-machine-learning-edition.md"
  },
  "id": "urn:aggr:item:c2fcc7b96110ca6ef552c5a6059f7e544984fdb9",
  "isBasedOn": {
    "@id": "https://blog.comma.ai/ml-bugs/"
  },
  "mainEntity": {
    "@id": "https://blog.comma.ai/ml-bugs/",
    "@type": "CreativeWork",
    "archivedAt": {
      "@id": "https://aggr.aymericbeaumet.com/items/blog-comma-ai/2026-09-16-bugs-that-broke-driving-machine-learning-edition/#webpage"
    },
    "author": [
      {
        "@type": "Person",
        "name": "Yassine"
      }
    ],
    "dateModified": "2026-09-16T20:00:00+00:00",
    "datePublished": "2026-09-16T20:00:00+00:00",
    "headline": "Bugs that broke driving: Machine Learning edition",
    "timeRequired": "PT11M",
    "url": "https://blog.comma.ai/ml-bugs/",
    "wordCount": 2272
  },
  "name": "Archived snapshot: Bugs that broke driving: Machine Learning edition",
  "preview": null,
  "reading_minutes": 11,
  "replicated_at": null,
  "source": "blog-comma-ai",
  "source_name": "comma.ai blog",
  "summary": "“We have solved self driving, we just need to fix the bugs.” Rumor has it that the Linux kernel averages around 0.5 bugs per 1,000 lines of code. Some bugs are easy to avoid or catch with tests and metrics. Others are very good at hiding. This is a sequel to Bugs that …",
  "tags": [],
  "temporalCoverage": "2026-09-19T21:30:23.395188495+00:00",
  "title": "Bugs that broke driving: Machine Learning edition",
  "url": "https://aggr.aymericbeaumet.com/items/blog-comma-ai/2026-09-16-bugs-that-broke-driving-machine-learning-edition/",
  "word_count": 2272
}